 Lila Modeler
Reference behaviour checklist (Bizagi Modeler public docs)
Fuente: LILA_MODELER_ESTRUCTURA.md, sección 3 ("Checklist de paridad con Bizagi"; ahí «paridad» es el criterio interno de aceptación, no el posicionamiento público). Esta tabla es una copia de esa sección con una columna Estado añadida para seguimiento de implementación; el contenido de las columnas Capacidad/Bizagi/Lila/Hito es el mismo que en el documento de estructura, que sigue siendo la fuente de verdad — ante cualquier discrepancia entre este archivo y LILA_MODELER_ESTRUCTURA.md, gana el documento de estructura y este archivo se corrige para reflejarlo, nunca al revés.
Fuente de la comparación original: ayuda oficial de Bizagi (niveles 1–4, escenarios, elementos no soportados), verificada el 2026-09-03. Bizagi no expone "4 niveles" en el motor: son qué parámetros están rellenos. Lila no reproduce los niveles como concepto de producto; el motor degrada: sin recursos ⇒ capacidad infinita, sin calendario ⇒ 24×7. Bizagi Modeler se cita aquí solo como referencia técnica e inspiración: este documento no plantea paridad de producto ni una alternativa comercial, solo un criterio interno de validación numérica (#289).
Estado refleja el estado de implementación en el repositorio, no el de este documento. Se actualiza fila por fila conforme cada capacidad queda implementada y probada (ver la prueba de aceptación del hito correspondiente en la sección 7 de LILA_MODELER_ESTRUCTURA.md), y lleva entre paréntesis los tickets que la cierran.
El comportamiento de referencia numérico, es decir la validación contra las corridas
publicadas por Bizagi Modeler, se comprueba en packages/engine/test/bizagi-parity.test.ts
(LILA-044), que simula los cuatro ejemplos de examples/bizagi-levels y compara cada número que
expected.json cita de la página oficial con tolerancia ±5 %. Lo que hoy no cuadra está en la
sección Diferencias documentadas del final, con su causa y su número: ninguna de esas
diferencias se ha cerrado ajustando un parámetro del escenario publicado.
Este archivo es una referencia técnica interna y conserva su nombre histórico
(BIZAGI_PARITY.md, bizagi-parity.test.ts) por continuidad con el código y los tickets que lo
citan; no implica una promesa pública de paridad con Bizagi Modeler.
| Capacidad | Bizagi | Lila | Hito | Estado |
|---|---|---|---|---|
| Start/End none, task (todas las variantes), sequence flow | ✓ | ✓ | M1 | Implementado (LILA-018, LILA-021, LILA-026) |
| Exclusive gateway con % por flujo (reparto equitativo por defecto) | ✓ | ✓ | M1 | Implementado (LILA-026); paridad verificada en el nivel 1 (test) |
| Inclusive gateway con % independientes | ✓ | ✓ | M1 | Implementado (LILA-026) |
| Parallel gateway fork/join | ✓ | ✓ | M1 | Implementado (LILA-026); paridad verificada en la rama Red de los niveles 2–4 |
| Subproceso embebido (aplanado); reusable = tarea con tiempo global | ✓ | ✓ | M1 | Implementado (LILA-019) |
| Timer intermedio como retardo | ✓ | ✓ | M1 | Implementado (LILA-026) |
| Llegadas: max arrival count + intervalo (constante o distribución) | ✓ | ✓ | M1 | Implementado (LILA-026). triggerCount sin interTriggerTimer = N llegadas en t = 0, como el nivel 1 de Bizagi (R-ARR-1, LILA-186); ver diferencia D1 |
| Processing time por tarea/evento, constante o distribución | ✓ | ✓ | M1 | Implementado (LILA-026); paridad verificada en el nivel 2 |
| Distribuciones: las 13 de BPSim 2.0 + constante + empírica | ✓ (subconjunto no documentado) | ✓ todas | M1 | Implementado (LILA-025) |
| Escenario: nombre, descripción, autor, versión, inicio, duración, unidad de tiempo, moneda, replicaciones, semilla | ✓ | ✓ (+ warmup, extends) |
M1 | Implementado (LILA-013, LILA-014) |
| Parada: duración o max arrival count, lo primero | ✓ | ✓ | M1 | Implementado (LILA-026); paridad verificada (la corrida oficial drena sus 2017 casos, ver D4) |
| Recursos: tipo rol/equipo, disponibilidad, costo fijo por token, costo por hora | ✓ | ✓ | M2 | Implementado (LILA-033); paridad verificada en el nivel 3 (test): utilización y costo de los seis recursos, en las dos corridas publicadas (3 y 2 enfermeras), todos dentro del ±5 % desde que D8 quedó resuelta |
| Asignación a tarea: uno o varios recursos, cantidad, AND / OR | ✓ | ✓ | M2 | Implementado (LILA-034, LILA-035) |
| Costo fijo por actividad | ✓ | ✓ | M2 | Implementado (LILA-036); paridad verificada en el nivel 3 (8057,6 contra 8063, −0,07 %). El 8063 no lo publica ninguna tabla: se deriva de los fixedCost por tarea del enunciado y de los conteos de instancias publicados (2·2017 + 1·2017 + 1·1006 + 1·1006), y el test lo declara así |
| Salidas por elemento: started, completed, tiempo min/max/avg/total, espera min/max/avg/std/total, costo fijo | ✓ | ✓ mismos nombres de columna | M2 | Implementado (LILA-036); nombres de columna revisados contra RESULTS_FORMAT.md. La paridad numérica que hay probada es la del proceso y la de los recursos del nivel 3 (ver D6 para el caso saturado); las columnas por elemento no están ancladas fila por fila |
| Salidas por recurso: utilización %, costo fijo, costo unitario, costo total | ✓ | ✓ | M2 | Implementado (LILA-036); paridad verificada en el nivel 3, las seis filas de la tabla publicada (p. ej. nurse 69,65 % contra 69,75 %) |
| Calendarios: recurrencia, hora de inicio, duración, vigencia; matriz recurso × calendario con calendario por defecto | ✓ | ✓ recurrencia semanal, mensual (día N del mes, o del primer al quinto/último día de la semana) y anual (fecha fija), más festivos (#82, R-CAL-12 … R-CAL-14). No cubierto: recurrencia «cada N semanas/meses», un rango de vigencia del calendario y la zona horaria propia con DST (timezone sigue reservado; R-CAL-15) |
M3 | Implementado (LILA-040, LILA-041, LILA-164, #82). LILA-164 añadió la capacidad por turno dentro de un mismo pool (capacity: [{calendar, capacity}], R-CAL-11): con ella el nivel 4 cuadra —ciclo medio, utilización y costo de los seis recursos— salvo el denominador de la utilización, que sigue vivo como D7 y tiene conversión exacta |
| What-if: varios escenarios, lado a lado, diferencias resaltadas | ✓ | ✓ (lila compare) |
M3 | Implementado (LILA-038, LILA-047) |
| Replicaciones (recomiendan 30) | ✓ solo en what-if | ✓ siempre, con IC 95 % | M2 | Implementado (LILA-027) |
| Export de resultados | Excel | CSV y XLSX | M2 | Implementado (LILA-037, LILA-046, #322) |
Importar .bpmn exportado por Bizagi |
— | ✓ solo diagrama: Bizagi no exporta parámetros de simulación (verificado en 5 archivos reales, solo colores en bizagi:) |
M0 | Implementado (LILA-020) |
| Modelador y entregables | ||||
| Varios procesos en un mismo proyecto, con una call activity que abre otro diagrama | ✓ un proyecto guarda varios diagramas; un subproceso reusable (call activity) referencia otro diagrama, abierto desde una ventana de navegación sobre la jerarquía del modelo | ✓ repositorio v2 (#498): pestañas del lienzo, una por proceso, guardadas juntas en el mismo proyecto; doble clic sobre una call activity cuyo calledElement coincide con el id BPMN de otro proceso lo abre con una miga «Volver a …», y doble clic sobre un subproceso colapsado hace drill-down en el sitio. Un proyecto de un solo proceso sigue guardando byte a byte en el formato v1 que abre la app de la beta.14 |
M5 | Implementado (#511, #498, #461) |
| Atributos extendidos definidos una vez por tipo de elemento y rellenados en cada elemento | ✓ una pestaña de «Atributos extendidos» por elemento, compartida por todos los elementos de ese tipo, varios tipos de dato (incluida una tabla), exportable para reusarla en otros modelos | ✓ definiciones de texto/número/lista/fecha por tipo de elemento (appliesTo), editadas en Propiedades y listadas bajo cada elemento en el documento del proceso; renombrar, retipar o borrar una definición que ya tiene valores pregunta antes, y nunca pierde un valor en silencio |
M5 | Implementado (#513, #509) |
| Gráficas junto a las tablas de resultados | ✗ la vista de Resultados es una tabla; «Export to Excel» transfiere esa misma grilla. (Los tipos de gráfica de Bizagi —línea/columna/pastel— son del Graphical Analysis/BAM del Work Portal, aparte, no de la vista de simulación del Modeler) | ✓ gráficas de barras bajo las tablas de Elementos del proceso, Recursos y Proceso en Resultados, en Comparar, y rasterizadas en el documento del proceso; cada barra repite el texto y el valor de su celda, y a los datos faltantes les toca una nota en vez de una gráfica en cero | M5 | Implementado (#512, #460) |
| Publicar el proceso como documento (Word / HTML) | ✓ «Publish to Word» (también PDF, Excel, MediaWiki, SharePoint): elige qué diagramas y elementos incluir, tres plantillas integradas (Aspose, Bizagi, Modeler) o una plantilla de Word propia | ✓ Archivo → Exportar documento del proceso (Word .docx o HTML): portada, diagrama, descripción del proceso, una sección por elemento en orden de flujo agrupada por carril, y luego las tablas del escenario y de resultados con las gráficas de la corrida. Sin plantillas ni campo de tabla de contenido |
M5 | Implementado (#454) |
| Exportar el diagrama como imagen e imprimirlo | ✓ Export → Image en PNG, SVG o JPG (no PDF directo; PDF es un formato de Publish; el export a Visio va aparte) | ✓ Archivo → Exportar como SVG… / PNG… / PDF… e Imprimir (⌘P/Ctrl+P); SVG conserva los colores del tema sobre su lienzo, PNG/PDF/impresión usan papel blanco con trazos negros, conservando los colores por elemento | M5 | Implementado (#451) |
| Extras que Bizagi no da | ||||
| p50/p90/p95 de ciclo y espera | ✗ | ✓ | M2 | Implementado (LILA-028) |
| Longitud de cola media/máx por actividad | ✗ | ✓ | M2 | Implementado (LILA-036) |
| Throughput por hora, costo por caso | ✗ | ✓ | M2 | Implementado (LILA-028) |
| Ranking de cuellos de botella | ✗ | ✓ | M2 | Implementado (LILA-036) |
| Event log por caso (CSV; XES después) | ✗ | ✓ | M2 | Implementado (LILA-037) |
| Espera fuera de horario separada de espera por recurso | ✗ (queja: "poca granularidad") | ✓ | M3 | Implementado (LILA-041); fue justo la métrica que delató la mitad de D7 que cerró LILA-164 (el workaround de pools por turno creaba una offHoursWait que Bizagi no tiene; hoy vale 0 en las cuatro tareas del nivel 4) |
| Determinismo por semilla, byte a byte | parcial | ✓ | M1 | Implementado (LILA-030, LILA-039, LILA-043) |
| macOS / Windows / Linux / navegador | ✗ (4.3 sigue Windows-only, sin editor web) | parcial: web y macOS probados; Windows y Linux construidos por CI, sin probar | M5 | Implementado: app web (probada en Chrome; Safari pendiente) y beta de macOS (probada). El instalador de Windows se adjunta a la beta pero está sin firmar y no se ha probado en una máquina Windows real; el AppImage de Linux lo construye CI, sin probar y no adjunto (estado por plataforma) |
| Importar parámetros del escenario desde Excel/CSV, revisados antes de aplicar nada | ✗ (el Modeler exporta la grilla de resultados a Excel; no se encontró en la documentación pública un camino de vuelta hacia los parámetros de simulación) | ✓ descarga una plantilla ya rellena, importa un Excel/CSV equivalente, revisa el reporte campo por campo (filas sin coincidencia/ambiguas y valores inválidos señalados), y luego aplica o deshace | M5 | Implementado (#514, #449) |
| Después | ||||
| Animación con contadores en vivo | ✓ | ✓ los tokens sobre el mapa de Resultados reproducen el log de eventos con contadores por elemento; token-simulation (MIT) conserva la parte didáctica | — | Implementado (#331) |
| Start quantity / completion quantity | ✓ | reservado | — | No planificado (v1) |
| Temporizador de borde interruptor sobre una tarea | ✓ | ✓ | — | Implementado (#81, primera tajada: SEMANTICS.md R-BND-1…9) |
| Temporizador de borde no interruptor sobre una tarea | ✓ | ✓ | — | Implementado (#81, segunda tajada: SEMANTICS.md R-BND-10…14) |
| Event-based gateway (ramas de tiempo y de mensaje) | ✓ | ✓ | — | Implementado (#81, tercera rebanada: SEMANTICS.md R-EVG-1…7) |
| Message/signal/link events sueltos, boundary events que no son de tiempo, boundary events sobre un subproceso, event-based gateway paralelo o que instancia | parcial | error de validación explícito hasta que un usuario lo pida | — | No planificado (v1) |
| Parámetros desde event logs (Bizagi 4.0 process mining) | ✓ | fase minería (proceso Python separado) | — | No planificado (v1) |
| No (Bizagi tampoco los simula) | ||||
Multi-instancia, complex gateway, choreography/conversation, transaccional, ad-hoc; leer .bpm propietario |
✗ | ✗ | — | Fuera de alcance |
Diferencias documentadas (LILA-044, corregidas en LILA-187)
packages/engine/test/bizagi-parity.test.ts simula examples/bizagi-levels/level-{1..4} tal
cual están committeados y compara, con tolerancia ±5 %, cada número que su expected.json cita
de la página oficial. Hasta LILA-187 el test tenía dos mitades —las réplicas publicadas, que no
cuadraban, y la misma comparación sobre un fixture aparte con la topología del diagrama oficial—
porque LILA-044 tenía prohibido tocar los ejemplos. LILA-187 llevó esa topología, las
probabilidades del gateway y las llegadas constantes a los propios model.bpmn y scenario.json,
así que la segunda mitad y su fixture desaparecieron: hoy hay una sola tabla.
Cada fila del test asegura de qué lado de la tolerancia está su número. Si una fila cambia de lado, el test se pone rojo y hay que actualizar el test y esta sección a la vez.
Resultado
Medido con 30 replicaciones en el test (los scenario.json publicados siguen en 1: las
replicaciones son una técnica de medición del test, no un parámetro de los ejemplos).
| Nivel | Número publicado | Lila | Causa |
|---|---|---|---|
| 1 | 1000 tokens creados y completados | 1000 (0 %) | — |
| 1 | rama Red (50 %) = 483 | 498,9 (+3,3 %) | — |
| 1 | rama Yellow (30 %) = 315 | 298,1 (−5,4 %) | D2 |
| 1 | rama Green (20 %) = 202 | 203,0 (+0,5 %) | — |
| 1 | ramas contra 1000 × p (500 / 300 / 200) |
−0,23 % / −0,63 % / +1,52 % | — |
| 2 | 2017 instancias iniciadas y completadas | 2017 (0 %) | — |
| 2 | ciclo mín 16 min | 16 min (0 %) | — |
| 2 | ciclo máx 33 min | 33 min (0 %) | — |
| 2 | ciclo medio 25 min 3 s | 25 min 4 s (+0,06 %) | — |
| 3 | ciclo mín 16 min (3 enf.) | 16 min (0 %) | — |
| 3 | ciclo máx 35 min (3 enf.) | 33,1 min (−5,3 %) | D5 |
| 3 | ciclo medio 25 min 15 s (3 enf.) | 25 min 4 s (−0,74 %) | — |
| 3 | utilización Call center agent 39,91 % (3 enf.) |
39,91 % (−0,01 %) | — |
| 3 | utilización Nurse 69,75 % (3 enf.) |
69,65 % (−0,14 %) | — |
| 3 | utilización Ambulance 49,76 % (3 enf.) |
49,63 % (−0,27 %) | — |
| 3 | utilización Quick attention vehicle 21,40 % (3 enf.) |
20,95 % (−2,09 %) | — |
| 3 | utilización Basic ambulance 19,44 % (3 enf.) |
20,21 % (+3,96 %) | — |
| 3 | utilización Receptionist 19,91 % (3 enf.) |
19,85 % (−0,30 %) | — |
| 3 | utilización Call center agent 38,09 % (2 enf.) |
38,09 % (+0,01 %) | — |
| 3 | utilización Nurse 99,85 % (2 enf.) |
99,72 % (−0,13 %) | — |
| 3 | utilización Ambulance 47,49 % (2 enf.) |
47,36 % (−0,27 %) | — |
| 3 | utilización Quick attention vehicle 20,42 % (2 enf.) |
20,01 % (−2,03 %) | — |
| 3 | utilización Basic ambulance 18,55 % (2 enf.) |
19,29 % (+4,01 %) | — |
| 3 | utilización Receptionist 19,00 % (2 enf.) |
18,95 % (−0,29 %) | — |
| 3 | ciclo mín 16 min (2 enf.) | 16,07 min (+0,42 %) | — |
| 3 | ciclo máx 10 h 57 min (2 enf.) | 665,8 min (+1,34 %) | — |
| 3 | ciclo medio 3 h 39 min 38 s (2 enf.) | 271,3 min (+23,5 %) | D6 |
| 3 | costo fijo de actividades 8063 (derivado, no publicado) | 8057,6 (−0,07 %) | — |
| 3 | costo Call center agent 6051 |
6051,0 (0 %) | — |
| 3 | costo Nurse 15 115 |
15 101,5 (−0,09 %) | — |
| 3 | costo Ambulance 30 314,13 |
30 232,8 (−0,27 %) | — |
| 3 | costo Receptionist 3018 |
3009,9 (−0,27 %) | — |
| 3 | costo Quick attention vehicle 11 139,86 |
10 907,9 (−2,08 %) | — |
| 3 | costo Basic ambulance 9844,65 |
10 234,6 (+3,96 %) | — |
| 3 | los seis costos, corrida de 2 enfermeras | los mismos valores y los mismos desvíos (el costo no depende de la capacidad) | — |
| 4 | 2017 instancias iniciadas y completadas | 2017 (0 %) | — |
| 4 | ciclo medio 25 min 26 s (1526 s) | 1521,5 s (−0,30 %) | — |
| 4 | offHoursWait de las 4 tareas con recurso por turno |
0 en las cuatro | — |
| 4 | utilización Call center agent 11,21 % |
11,21 % (−0,04 %) | D7 (denominador convertido) |
| 4 | utilización Nurse 16,21 % |
16,30 % (+0,54 %) | D7 (denominador convertido) |
| 4 | utilización Ambulance 11,49 % |
11,61 % (+1,06 %) | D7 (denominador convertido) |
| 4 | utilización Quick Attention Vehicle 7,55 % |
7,35 % (−2,60 %) | D7 (denominador convertido) |
| 4 | utilización Basic Ambulance 5,60 % |
5,67 % (+1,33 %) | D7 (denominador convertido) |
| 4 | utilización Receptionist 6,90 % |
6,97 % (+0,98 %) | D7 (denominador convertido) |
| 4 | costo Call center agent 6051 |
6051,0 (0 %) | — |
| 4 | costo Nurse 15 050 |
15 101,5 (+0,34 %) | — |
| 4 | costo Ambulance 29 922,4 |
30 232,8 (+1,04 %) | — |
| 4 | costo Quick Attention Vehicle 11 193,94 |
10 907,9 (−2,56 %) | — |
| 4 | costo Basic Ambulance 10 095,15 |
10 234,6 (+1,38 %) | — |
| 4 | costo Receptionist 2979 |
3009,9 (+1,04 %) | — |
| 4 | Arrive BA espera máx 15 min (900 s) | 970 s (+7,78 %) | D7 (residuo) |
| 4 | Arrive BA espera media 0,74 min (44,4 s) | 33,5 s (−24,5 %) | D7 (residuo) |
Los niveles 1, 2 y 3 cuadran dentro del ±5 % salvo tres residuos documentados: D2 (nivel 1,
rama Yellow contra la corrida única de Bizagi) y D5 y D6 (nivel 3). El nivel 4 cuadra desde
LILA-164 en ciclo, utilización y costo de los seis recursos; le quedan dos residuos: las dos
esperas de Arrive at patient place BA y —para las utilizaciones— la conversión de denominador,
las dos mitades de lo que hoy es D7. Las diferencias vivas hoy son, por tanto, D2, D5, D6 y D7;
D1, D3, D4 y D8 quedaron resueltas en LILA-186/187.
Las utilizaciones del nivel 4 son las convertidas al denominador de Bizagi. Sin convertir, Lila
publica sobre su ventana de medida [warmup, t_stop] = 10 862 min: 44,75 % · 64,82 % · 46,18 % ·
29,79 % · 22,24 % · 27,36 %, en el mismo orden. Son los mismos segundos ocupados divididos por otro
denominador; la fórmula está en D7.
Causas
D1 — triggerCount sin interTriggerTimer (resuelta en LILA-186). Era un hueco del contrato
de Lila, no un desajuste con Bizagi: R-ARR-1 solo generaba casos en un start con
interTriggerTimer, así que el nivel 1 (max arrival count 1000 y ningún campo de tiempo, porque el
nivel 1 no los habilita) salía con cero llegadas y el aviso W-START-SIN-LLEGADAS. R-ARR-1 dice
ahora que triggerCount sin interTriggerTimer equivale al default constant 0, es decir N
llegadas en t = 0, que es lo que hace Bizagi. El aviso queda para el start que no declara
ninguno de los dos campos.
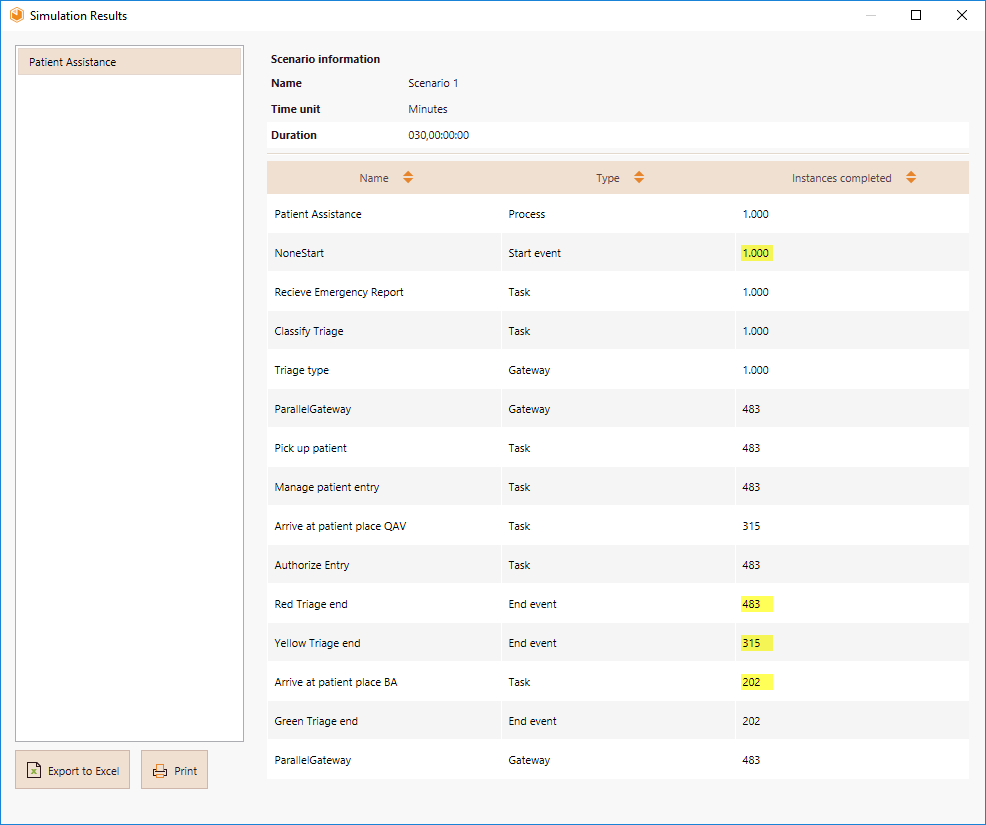
D2 — la rama del 30 % contra una corrida única de Bizagi. Los tres conteos publicados
(483 + 315 + 202) son una sola corrida de 1000 tokens; el 315 se desvía por sí mismo un +5 % de su
propia probabilidad configurada (30 %). Contra 1000 × p, que es lo que de verdad valida el nivel
1, las tres ramas cuadran (−0,23 %, −0,63 %, +1,52 %). Anotado además: level-1/expected.json
etiquetaba los tres conteos como green/yellow/red al revés (corregido en LILA-187). La
prosa de la página solo da la suma «(483+315+202)», pero la tabla de resultados que la acompaña
(processvalidation42.png) los publica
fila por fila: «Red Triage end 483 · Yellow Triage end 315 · Green Triage end 202». La corrida rota
(processvalidation43.png) confirma la
lectura: «Red Triage end 1006 · Yellow Triage end 311 · Green Triage end 186», y el 1006 solo puede
ser la rama del Parallel Gateway sin convergencia.

D3 — la topología reconstruida de los niveles 2–4 no era la del diagrama oficial (resuelta en
LILA-187). examples/bizagi-levels/level-{2,3,4}/model.bpmn reconstruía el «Emergency attendance
process» como siete tareas en secuencia con un XOR de vehículo al final. El diagrama de la página
(simulationexample2.png, el mismo proceso en los cuatro niveles), que es el que reproducen hoy
los cuatro model.bpmn, es:
Recieve Emergency Report (4 min) → Classify Triage (5 min) → XOR "Triage type"
  ├ Red    50 % → AND ( Manage patient entry 11 min ‖ Pick up patient 20 min ) → Authorize Entry 4 min → fin
  ├ Yellow 30 % → Arrive at patient place QAV  7 min → fin
  └ Green  20 % → Arrive at patient place BA  10 min → fin
Consecuencias medidas: con la secuencia hay un solo camino de 51–54 min (contra 16 / 33 / 25 min
publicados) y la enfermera consume 16 min por caso en vez de 10,5 (5 min siempre + 11 min solo en
el 50 % Red), o sea 3,2 enfermeras de carga contra 2,1 — por eso satura al 99,9 % con tres, cuando
Bizagi publica 69,75 %. Con la topología oficial los tres números del nivel 2 salen exactos y la
utilización de los seis recursos del nivel 3 cuadra dentro del 4 %. Era una errata de la réplica
(LILA-010), no del motor: LILA-187 la corrigió en model.bpmn y añadió al escenario las
probabilidades del gateway Triage type publicadas en prosa en level_1_example.htm.
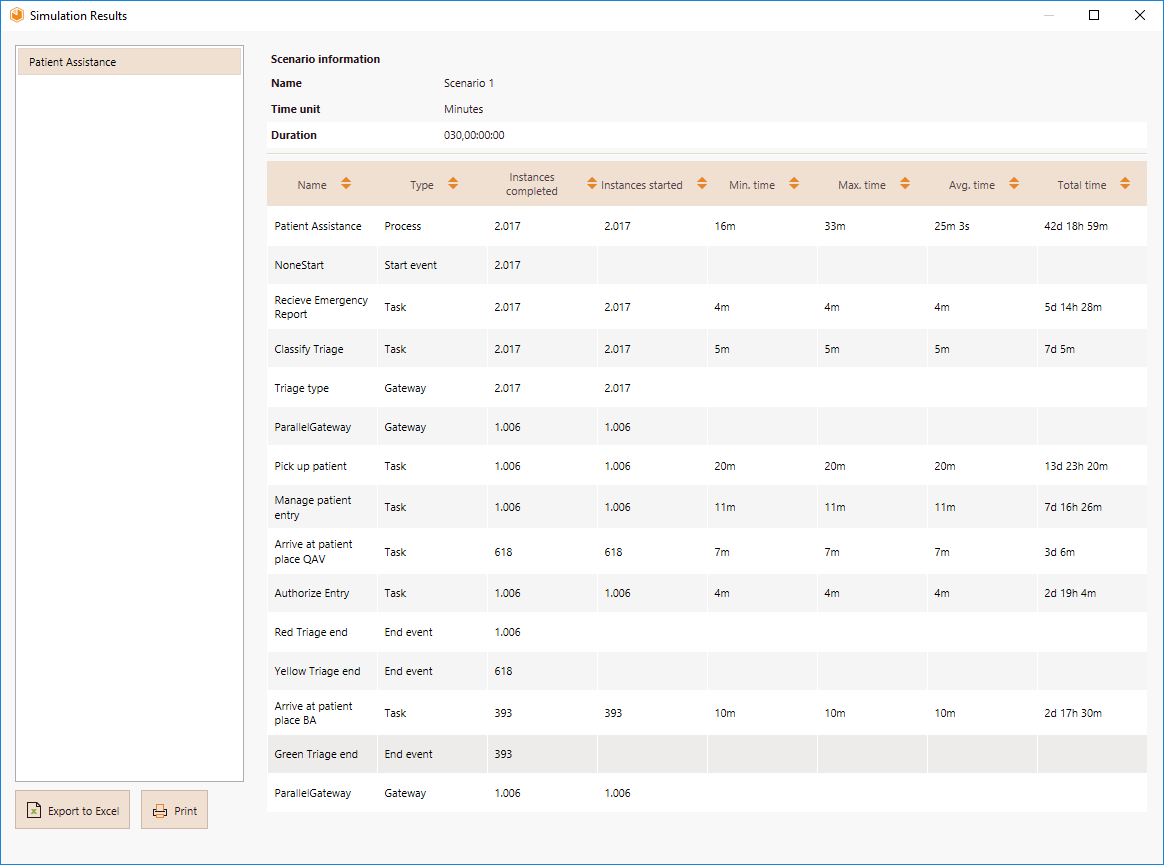
D4 — llegadas constantes y drenado (resuelta en LILA-187). La corrida publicada
(processvalidation47.png) trae
exactamente 2017 instancias iniciadas y 2017 completadas (10080 / 5 + 1), con Duration
030,00:00:00 en la cabecera del informe: 30 días de reloj para una semana de llegadas, o sea que
Bizagi dejó drenar la corrida: imposible con un Poisson de media 5 min, y prueba de
que el ejemplo usó el control de intervalo constante de 5 min, no la distribución exponencial
que declara el escenario publicado. Además Bizagi drena la corrida (0 casos en vuelo) mientras el
escenario publicado corta a la semana y deja casos en vuelo que, por LILA-036, no entran en las
medias. Con interTriggerTimer constante de 300 s, triggerCount 2017 y sin duration (R-ARR-3:
la corrida acaba al vaciarse el heap) —que es lo que declaran hoy los scenario.json de los
niveles 2, 3 y 4— Lila reproduce las 2017 instancias y el denominador de utilización de Bizagi:
callCenterAgent sale 39,91 % contra 39,91 % publicado.
D5 — el máximo del nivel 3 con 3 enfermeras (−5,3 %). Bizagi publica 35 min = los 33 min del
camino Red más 2 min de espera de enfermera que en su corrida cayeron en el camino crítico. En la
nuestra la espera máxima de Classify Triage es de segundos y el máximo se queda en los 33 min del
camino puro. Es la cola de la distribución de un único máximo, no una diferencia de definición: la
media cuadra al 0,74 % y la utilización al 0,14 %.
D6 — el caso saturado del nivel 3 (2 enfermeras), media +23,5 %. Con 2 enfermeras el sistema está por encima de su capacidad (ρ ≈ 1,05) y la cola crece durante toda la corrida, así que la media depende de la forma del transitorio, no del estado estacionario. Mínimo (+0,4 %), máximo (+1,3 %) y utilización (−0,13 %) cuadran; la media no, porque en Bizagi la razón media/máximo de la espera vale 0,40 y en Lila 0,49 — es decir, la cola de Bizagi crece sublinealmente y la de Lila linealmente, que es lo que produce una acumulación de trabajo constante desde t = 0. Sin la corrida original de Bizagi no se puede ir más allá; queda como el único residuo del nivel 3.
D7 — el nivel 4: resuelta la capacidad por turno (LILA-164), vivo el denominador de la utilización. Bizagi hace variar la plantilla por turno (2 / 2 / 1 agentes de call center, etc.) sin que el recurso deje de existir: los tres turnos cubren las 24 h y no hay tiempo cerrado.
Lo que cerró LILA-164. Hasta entonces SCENARIO_FORMAT.md v1 no admitía eso y la réplica lo
modelaba con tres pools —uno por turno, cada uno con su calendar— seleccionados con
selection: "or". El efecto colateral estaba medido: el calendario efectivo de la tarea pasaba a
ser el del turno concedido (R-CAL-4), el trabajo se pausaba al cerrar el turno y aparecía una
offHoursWait de 59,7 min por caso que bajo la semántica de Bizagi tiene que ser 0; el ciclo medio
salía a 84,4 min (+232 %), y la utilización y el costo se publicaban por turno en vez de por rol.
R-CAL-11 (resources[pool].capacity: [{ calendar, capacity }], docs/SEMANTICS.md § 12) es un
solo pool por rol con la tabla «Resource | Morning shift | Day shift | Night shift» de la página
tramo a tramo, y con ella:
offHoursWait= 0 en las cuatro tareas con recurso por turno (la unión de los tres turnos es un 24×7): era el desvío entero;- ciclo medio 1521,5 s contra los 1526 s publicados (−0,30 %);
- utilización y costo se reportan por rol, seis filas, las de Bizagi, y los doce números caen
dentro del ±5 % (peor caso −2,60 %,
Quick Attention Vehicle); Arrive at patient place BAvuelve a hacer cola (máx 970 s) porque la capacidad baja a 1 en el turno de tarde; con la capacidad fija del nivel 3 era exactamente 0.
Lo que sigue vivo: el denominador. En el nivel 4 Bizagi divide por la duración declarada del
escenario (43 200 min = los 30 días del campo Duration del informe), no por el instante de fin de
corrida (≈ 10 862 min) que sí usa en el nivel 3 y que es lo que fija R-CAL-9. Son 4,0× de
diferencia. Es una decisión de contrato, no un bug, y Lila no cambia de denominador: mantiene
[warmup, t_stop], que es la ventana en la que de verdad midió. La conversión es exacta sobre
busyTime:
util_bizagi = busyTime / Σᵢ (capacityᵢ × openTimeᵢ sobre la duración declarada)
            = util_lila × ventana_lila / duración_declarada
y con los tres turnos de 8 h ese sumatorio vale (Σᵢ capacityᵢ / 3) × 43 200 min, que es
literalmente la cuenta publicada: Call center agent 8068 min / ((2+2+1)/3 × 43 200 min) = 11,21 %,
exacta al segundo decimal en los seis recursos contra
calendaranalysis2.png.

Aplicada, las seis filas cuadran holgadamente (la tabla de arriba): −0,04 % · +0,54 % · +1,06 % ·
−2,60 % · +1,33 % · +0,98 %. La segunda forma —la regla de tres util_lila × ventana / duración declarada— es la versión de bolsillo y solo coincide del todo cuando la ventana cubre un número
entero de periodos del patrón de turnos; aquí no lo cubre (la corrida se agota a los 10 862 min,
7,54 días) y el sesgo del corte a media franja llega al 1,8 % en quickAttentionVehicle, el rol
cuyo turno de tarde vale el doble que los otros dos. El test comprueba las dos y acota esa
diferencia al 3 %: es el error de la regla de tres, no del motor.
Residuo: las dos esperas de Arrive at patient place BA. Máximo 970 s contra 900 s publicados
(+7,8 %) y media 33,5 s contra 44,4 s (−24,5 %). Son de una corrida única de Bizagi sobre un pool
al 5,6 % de utilización, donde solo hay cola cuando dos casos coinciden en el turno de tarde (una
sola ambulancia básica); el reparto por rama de esa corrida tampoco es el nuestro (Bizagi 403
instancias BA, Lila 409). Es ruido de la corrida de referencia, del mismo tipo que D2, y no se
relaja la tolerancia por él.
Nota de mapeo (corregida en LILA-187). expected.json llamaba waitTimeSeconds a lo que la
tabla de Bizagi titula «Min./Max./Avg. time» del proceso. Esa columna es tiempo de ciclo
(procesamiento + espera), y su equivalente en Lila es process.cycleTime, no process.waitTime
(que es solo resourceWait + offHoursWait y en el nivel 2, sin recursos, vale 0 por R-DEG-1). El
campo se llama hoy cycleTimeSeconds en los cuatro expected.json.
D8 — los dos vehículos están cruzados en la tabla de requerimientos de la página (resuelta en
LILA-187). La tabla «Activity | Resource | Quantity» del nivel 3 asigna «Arrive at patient place
QAV → Basic ambulance» y «Arrive at patient place BA → Quick attention vehicle», y la réplica lo
reproducía verbatim. Los
carriles del diagrama y los resultados publicados dicen lo contrario: en
resourcesanalysis3.png Quick
Attention Vehicle sale al 21,40 %, que es 618 × 7 min / (2 × 10 108 min) — la tarea QAV — y Basic
Ambulance al 19,44 % = 393 × 10 min / (2 × 10 108 min) — la tarea BA. Con esa lectura los seis
denominadores dan el mismo instante de fin de corrida (10 108 min con 3 enfermeras, 10 591 con 2),
lo que confirma a la vez la fórmula busy / (capacidad × t_fin) y el cruce.

Para la utilización el cruce solo intercambia dos etiquetas, porque los dos pools tienen
capacidad 2. Para el costo no: los precios difieren (25 y 0,3 /h contra 18 y 0,22 /h), así que
con el cruce la réplica cobraba la tarea QAV a 25/token en vez de 18 y la tarea BA a 18 en vez de
25 (medido entonces: +36,0 % y −25,1 %). LILA-187 puso en scenario.json la asignación que cuadra
con los costos publicados, y los dos costos pasan a −2,08 % y +3,96 %.
Ver también: docs/es/COMING-FROM-BIZAGI.md (la guía de usuario para
quien llega desde Bizagi Modeler: los cuatro niveles como pasos de Simular, el mapa pantalla por
pantalla y estas diferencias en lenguaje llano).
Ver también: docs/RESULTS_FORMAT.md (definición de las columnas de salida mencionadas en "Salidas por elemento"/"Salidas por recurso"), docs/BPMN_EXTENSION.md (namespace lila: e ids), docs/DECISIONS.md (ADR que sustentan estas decisiones) y BACKLOG.md (desglose en tickets por hito).